
📝 Publications

Revisiting Automated Evaluation for Long-form Table Question Answering
Yuqi Wang, Lyuhao Chen, Songcheng Cai, Zhijian Xu, Yilun Zhao
- LfTQA-Eval is a meta-evaluation dataset containing 2,988 human-annotated examples, designed to evaluate the performance of current automated metrics in assessing LLM-based LFTQA systems, with an emphasis on faithfulness and comprehensiveness.

VisCoder2: Building Multi-Language Visualization Coding Agents
🌐 Project | 🤗 Huggingface | 💻 Code
Yuansheng Ni*, Songcheng Cai*, Xiangchao Chen*, Jiarong Liang, Zhiheng Lyu, Jiaqi Deng, Kai Zou, Ping Nie, Fei Yuan, Xiang Yue, Wenhu Chen
- VisCoder2 introduces a multi-language visualization coding benchmark, dataset, and model family, enabling language models to generate, execute, render, and iteratively debug visualization code across diverse programming languages.

Songcheng Cai*, Zhiheng Lyu*, Yuansheng Ni, Xiangchao Chen, Baichuan Zhou, Shenzhe Zhu, Yi Lu, Haozhe Wang, Chi Ruan, Benjamin Schneider, Weixu Zhang, Xiang Li, Andy Zheng, Yuyu Zhang, Ping Nie, Wenhu Chen
- SWE-QA-Pro introduces a repository-level QA benchmark and agentic training framework for code understanding, enabling LLM to navigate, reason over, and verify real-world software repositories.

RewardHarness: Self-Evolving Agentic Post-Training
Yuxuan Zhang*, Penghui Du*, Bo Li*, Cong Wei*, Junwen Miao, Huaisong Zhang, Songcheng Cai, Yubo Wang, Dongfu Jiang, Yuyu Zhang, Ping Nie, Wenhu Chen, Changqian Yu, Kelsey R. Allen
- RewardHarness introduces a self-evolving pipeline that turns execution feedback and automatic verifiers into scalable reward signals for agentic post-training, cutting the reliance on expensive human preferences.
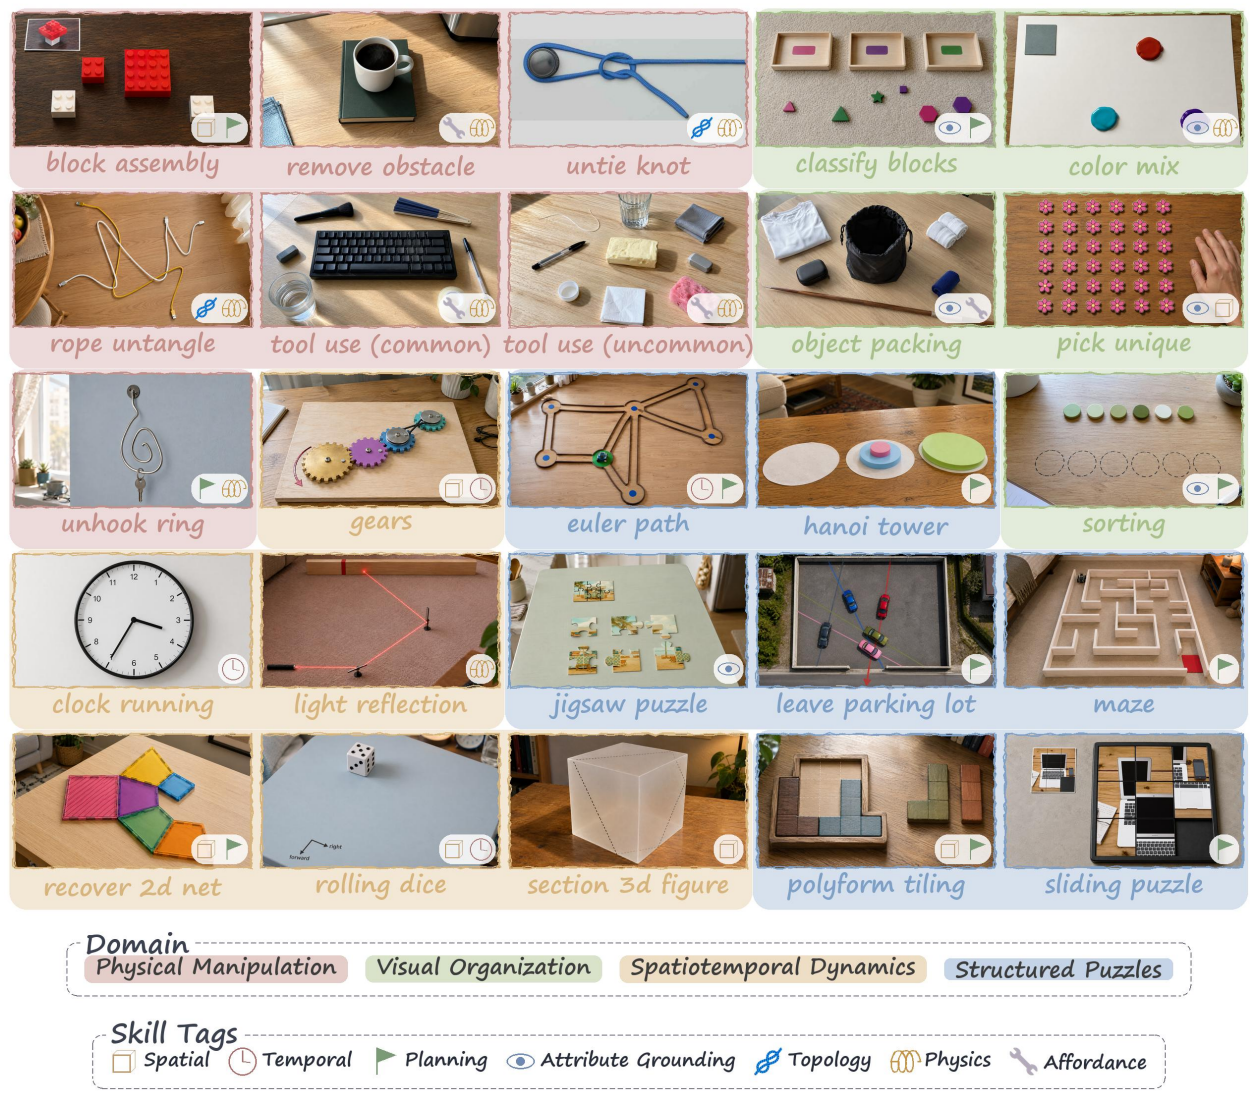
VGI-Bench: Probing Visual Intelligence in Video Generation Models
🌐 Project | 🤗 Huggingface | 💻 Code
Xuan He, Cong Wei, Yuhao Cheng, Linrui Ma, Yuxuan Zhang, Zuojun Li, Yuhao Wen, Jize Jiang, Zeyi Liu, Yuren Hao, Songcheng Cai, Keming Wu, Penghui Du, Kai Zou, Rui Yang, Chenkai Sun, Ke Yang, Ping Nie, Kelsey R. Allen, Chenglong Wang, Michel Galley, Jianfeng Gao, ChengXiang Zhai
- VGI-Bench evaluates visual reasoning in video generation models across 27 tasks and 810 instances, assessing both task completion and the validity of the generated process.
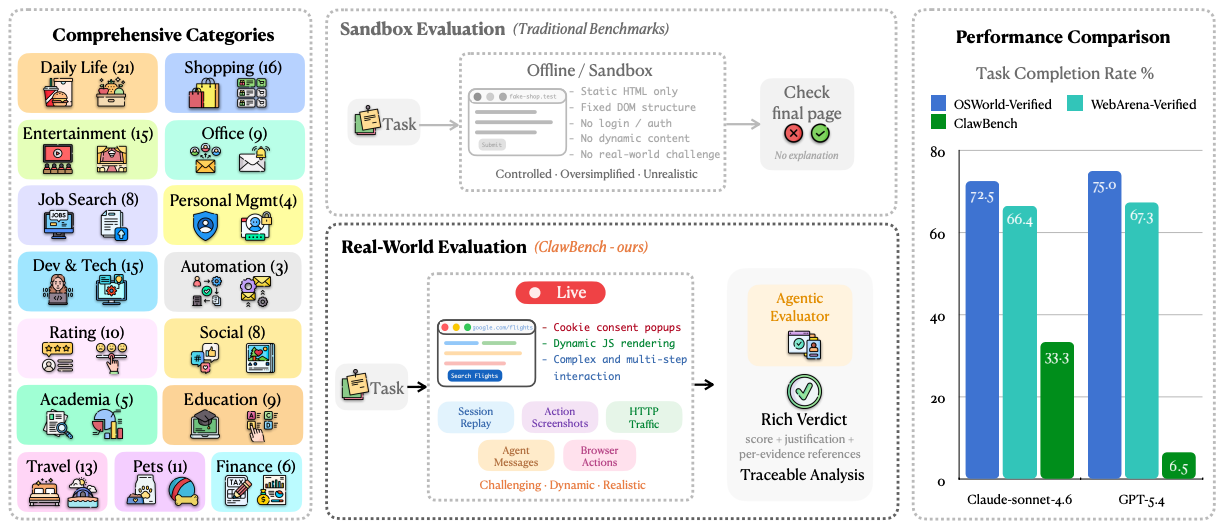
ClawBench: Can AI Agents Complete Everyday Online Tasks?
🌐 Project | 🤗 Huggingface | 💻 Code
Yuxuan Zhang, Yubo Wang, Yipeng Zhu, Penghui Du, Junwen Miao, Xuan Lu, Zhuofeng Li, Xingwei Qu, Zhengkang Guo, Yuanzhe Shen, Dingjie Song, Han Zhou, Tuney Zheng, Xian Wu, Hao Yu, Songcheng Cai, Yi Lu, Yunzhuo Hao, Minyi Lei, Liang Chen, Kai Zou, Huifeng Yin, Wendong Xu, Dongfu Jiang, Ping Nie, Jiaheng Liu, Wenhu Chen, Kelsey R. Allen
- ClawBench evaluates AI agents on 153 everyday online tasks across 144 live websites, using an interception layer to verify task completion while blocking final submissions.
📄 Preprints
- arXiv 2026 LitTraceQA: A Benchmark for Multi-Stage Grounding and Verification in Scientific Question Answering
Xuye Liu, Yimu Wang, Peng Shi, Bo Xue, Xiangrui Ke, Songcheng Cai, Kath Choi, Di Wu, Freda Shi, Krzysztof Czarnecki - arXiv 2026 ATTRICITE: Training an Open 4B Model for Citation Recovery toward Faithful Attribution
Yee Man Choi, Xuehang Guo, Songcheng Cai, Yimu Wang, Yi R. Fung, Qingyun Wang